четверг, 1 июля 2021 г.

К проблеме самообновляющегося учебника

Прогресс технологий идет настолько быстро, что становятся бессмысленными статические источники информации, например, статические учебники и онлайн-курсы. Содержание должно непрерывно обновляться и изменяться. Конечно, есть методы и инструменты более динамичные: блоги, агрегаторы контента типа scoop.it и многое тому подобное. Но все же привычный академический формат, рассчитанный не на исследователей, а именно школяров – это учебник, к которому очень близок автоматизированный онлайн-курс. Их непрерывное обновление не под силу человеку - здесь должен быть привлечен ИИ и продвинутые NLP-модели. То есть адекватные прогрессу учебные материалы должны самообновляться, обладать функциями парсера новостей по теме и функциями переформатирования старых и компиляции новых текстов.

Например, при подготовке главы о Больших генеративных моделях (БГМ) в онлайн-курсе и учебном пособии «Искусственный интеллект в образовании», автор столкнулся с тем, что текст и видео за время их подготовки к публикации в онлайн-курсе стабильно устаревает. Только было подготовлено и записано видео о GPT-3, как появилась необходимость дополнить главу информацией о модели Сбера ruGPT-3 Large (ноябрь 2020). Следом появилась информация о новой модели Google на 1.6 трлн. параметров. АК в июне 2021 г., когда весь курс был окончательно подготовлен к реализации «как назло» появляется не только информация о китайской модели Wu Dao, но и отечественной, пусть и более скромной  YaLM от Яндекса, да еще и с демонстрационным интерфейсом  «Балабоба».

Решаема ли эта проблема – создание «умного» динамического учебника? Попробуем порассуждать.

Новая информация может противоречить существующему содержанию учебника, а может дополнять его.


1.      Предположим,  что дополняет. Каков может быть подход?

В первом приближении, при условии, что текст был написан добросовестным автором, можно предположить, что дополнения могут поступать только от источников, которые появились позже окончания работы над текстом.

В этом случае алгоритм может быть таким:

1)      Система анализирует текст (возможно происходит предварительная суммаризация-реферирование), выделяя ключевые понятия, слова, термины

2)      При этом должны быть исключены n-граммы, «заужающие» и затемняющие поиск, например, разного рода именованные сущности – но универсального подхода здесь нет. Например, для поиска информации о новых БГМ, д.б. исключены фирменные, географические названия и прочие наименования. А для учебника по истории Южной Америки нет.

3)      Далее м.б. осуществлен поиск-парсинг новой информации, причем поисковая модель должна уметь определять первоисточник информации и его дату публикации. По аналогии как  tineye ищет оригинал картинки, где и когда она была впервые опубликована. 

4)      Все эти этапы в принципе решаемы и не новы: агрегация новостей дело не новое. Это вопросы источников информации, релевантности поиска. Наверное, можно обойтись стандартными и полуавтоматическими решениями. 

5)      Затем система должна решить: содержит ли найденный контент что-либо новое по сравнению с имеющемся в тексте. То есть должна научиться определять «степень новизны». Непростой вопрос, связанный с задачами поиска плагиата только в самом первом приближении.

6)      И далее, если на предыдущем шаге получено значение «да», новизна имеется - информация должна быть очищена от несущественных, повторяющихся частей, возможно сжата. А затем должно быть определено куда она должна быть вставлена и, что  совсем не тривиально, стилизована под общий текст.    

Итак, перечислим еще раз задачи, которые необходимо решить:

·         Анализ исходного текста для целей поиска тематической информации

·         Отбор источников информации, парсинг информации с них, тайм-селекция

·         Определение новизны информации по отношению к исходному тексту

·         Стилизация информации и ее объединение с исходными текстом


2.      Исправление содержания

Мне неизвестны решения такого комплексного характера. Хотя, очевидно, что по частям решения есть. Не секрет, что определенной моделью глобального динамического учебника является Википедия. Правда, изменения в ней генерируются множеством людей-редакторов, в том числе на волонтерской основе. Не чужда Википедия и использованию ИИ. Однако до последнего времени его применение ограничивалось несколькими простыми задачами:

·         Препятствие вандализму (когда кто-то намеренно добавляет в энциклопедию неправдивую информацию), например, программа ClueBot NG;

·         Создание заготовок статей, вставка сведений в заранее определенные шаблоны и т.п.;

·         Создании и исправлении ссылок, проверке правописания, определение нарушения копирайта

Более продвинутый вариант предлагают исследователи из  Массачусетского технологического института (см. популярное изложение в Офисе новостей MIT за 12.02.2021 г. https://news.mit.edu/2020/automated-rewrite-wikipedia-articles-0212). В статье «Automatic Fact-Guided Sentence Modification»// Darsh J Shah, Tal Schuster, Regina Barzilay Computer Science and Artificial Intelligence Lab Massachusetts Institute of Technology. https://arxiv.org/pdf/1909.13838.pdf авторы ставят задачу исправления и изменений в статьях Википедии. При этом основной задачей является именно исправление, а не добавление – через выделение противоречий между старой и новой информацией и изменение старой.  Это сложная задача ограниченной генерации, поскольку вывод должен быть согласован с новой информацией и вписываться в остальную часть существующего документа.

 В статье, представленной на конференции AAAI по искусственному интеллекту, исследователи описывают систему генерации текста, которая определяет и заменяет конкретную информацию в соответствующих предложениях Википедии, сохраняя язык, похожий на то, как люди пишут и редактируют. Идея состоит в том, что люди будут вводить в интерфейс неструктурированное предложение с обновленной информацией, не беспокоясь о стиле или грамматике. Затем система выполнит поиск в Википедии, найдет соответствующую страницу и устаревшее предложение и перепишет их по-человечески. Исследователи говорят, что в будущем есть потенциал для создания полностью автоматизированной системы, которая определяет и использует самую свежую информацию из Интернета для создания переписанных предложений в соответствующих статьях Википедии, отражающих обновленную информацию.

Согласитесь, это предложение наиболее близко к идее самообновляющегося учебника. Но давайте посмотрим как действует эта технология. Что следует учитывать и при каких условиях задача может быть достижимой.

Во-первых назначением системы является не изменение всей статьи, а только «точных частей статей». В качестве входных данных система принимает «устаревшее» предложение из статьи в Википедии, а также отдельное «утверждение», содержащее обновленную и противоречивую информацию. Она должна автоматически удалять и сохранять определенные слова в устаревшем предложении на основе информации в заявлении, чтобы обновить факты, но сохранить стиль и грамматику. Это простая задача для людей, но новая в машинном обучении.

Например, предположим, что это предложение (выделено жирным шрифтом) необходимо обновить: «Фонд A считает 28 из своих 42 миноритарных пакетов акций в операционно активных компаниях особенно важными для группы». Предложение с обновленной информацией может гласить: «Фонд А считает 23 из 43 миноритарных долей участия значительными». Система найдет соответствующий текст в Википедии для «Фонда А» на основе заявления. Затем он автоматически удаляет устаревшие числа (28 и 42) и заменяет их новыми числами (23 и 43), сохраняя при этом предложение точно таким же и грамматически правильным.

Как это работает:

Система была обучена на популярном наборе данных, который содержит пары предложений, в которых одно предложение является утверждением, а другое - соответствующим предложением Википедии. Каждая пара помечается одним из трех способов: «согласен», что означает, что предложения содержат совпадающую фактическую информацию; «Не согласен», что означает, что они содержат противоречивую информацию; или «нейтральный», если для любого ярлыка недостаточно информации. Система должна заставить все несогласные пары согласиться, изменив устаревшее предложение, чтобы оно соответствовало утверждению. Это требует использования двух отдельных моделей для получения желаемого результата.

Первая модель - это классификатор для проверки фактов, предварительно обученный маркировать каждую пару предложений как «согласен», «не согласен» или «нейтральный», - который фокусируется на несогласных парах.

Вместе с классификатором работает настраиваемый модуль «маскировки нейтралитета», который определяет, какие слова в устаревшем предложении противоречат утверждению. Модуль удаляет минимальное количество слов, необходимых для «максимизации нейтралитета» - это означает, что пара может быть помечена как нейтральная. Это отправная точка: хотя предложения не совпадают, они больше не содержат явно противоречивой информации. Модуль создает двоичную «маску» над устаревшим предложением, где 0 ставится над словами, которые, скорее всего, требуют удаления, а 1 ставится поверх хранителей.

После маскирования для генерации окончательного выходного предложения используется новая структура с двумя кодировщиками и декодерами. Эта модель изучает сжатые представления утверждения и устаревшего предложения. Работая совместно, два кодировщика-декодера объединяют несходные слова из заявки, перемещая их в места, оставшиеся свободными после удаленных слов (тех, которые покрыты нулями) в устаревшем предложении.

Результат:

В одном тесте модель получила более высокие оценки, чем все традиционные методы, с использованием метода под названием «SARI», который измеряет, насколько хорошо машины удаляют, добавляют и сохраняют слова по сравнению с тем, как люди изменяют предложения. Они использовали набор данных с вручную отредактированными предложениями Википедии, которых модель раньше не видела. По сравнению с несколькими традиционными методами создания текста, новая модель была более точной в обновлении фактов, а ее результаты более напоминали человеческое письмо. В другом тесте краудсорсинговые люди оценили модель (по шкале от 1 до 5) на основе того, насколько хорошо ее выходные предложения содержали фактические обновления и соответствовали грамматике человека. Модель получила средний балл 4 за фактическое обновление и 3,85 за соответствие грамматике.


№

Старый текст

Новая информация

Результат исправления

1

Родившись в Лоутоне , штат Оклахома , и выросший в Анахайме , штат Калифорния, Хилленбург в детстве увлекся небом, а также развил интерес к искусству

Стивен Хилленбург в детстве был очарован океаном

Родившись в Лоутоне , штат Оклахома , и выросший в Анахайме , штат Калифорния, Хилленбург в детстве увлекся океаном, а также проявил интерес к искусству .

2

Немецкая Startups Group считает, что 28 из 42 миноритарных акционеров в действующих компаниях имеют особое значение для группы.

Он считает значимыми 23 из 43 миноритарных акционеров

Немецкая Startups Group считает, что 23 из 43 миноритарных акционеров в действующих компаниях имеют особое значение для группы.


3

Сиквел  Rio 2, был выпущено 11 апреля 2012 года

Сиквел Rio вышел 11 апреля 2014 года

Сиквел Rio 2, было выпущено 11 апреля 2014 года

4

Альберт С. Редди  родился 28 марта 1940 года  - канадский кино - и телевизионный продюсер

1930 году родился Альберт С. Редди

Альберт С. Редди  родился 18 декабря 1930 года -китайский кино - и телевизионный продюсер*

*В последнем примере, несмотря на то, что модель выдает правильный 1930 год, она изменяет месяц и национальность на выдуманные, неправильные значения. Это результат слишком агрессивного удаления.

Итак, что можно сказать о предложенном методе и о возможности его применения для решения задачи саморедактирующегося учебника

  1. 1.      Очевидно, что его использование позволяет достичь только частичного самообновления, а именно: изменения на основе выделения противоречия между старой и новой информацией
  2. 2.      Как понятно из примеров пока работают лишь простые и в основном количественные различия и изменения
  3. 3.      Для обучения модели необходимо сформировать достаточное количество размеченных пар предложений
  4. 4.      Проблема парсинга необходимых изменений в учебник здесь не ставится: новый фрагмент должен находить и «скармливать» системе человек

Тем не менее мы видим здесь определенный шаг в направлении создания самообновляющегося учебника.


вторник, 29 июня 2021 г.

 Пробую возобновить работу в блоге. При этом ставлю следующие цели:

1. Репост статей и сообщений, имеющих отношение к использованию искусственного интеллекта в образовании. Такая себе новостная лента событий и публикаций, которые ты не успеваешь анализировать, но не хочешь, чтобы эта информация затерялась

2. Собственные сообщения частного характера, в которых представлен предварительный анализ тенденций, сервисов и прочего, имеющего отношение к ИИ в образовании  (типа сравнений сервисов, соображений о перспективах использования и т.п.)   

Связь компьютерного зрения с технологией обработки естественного языка. Создание изображений из текста. Strolling Cities - кейс конца мая 2021 г.

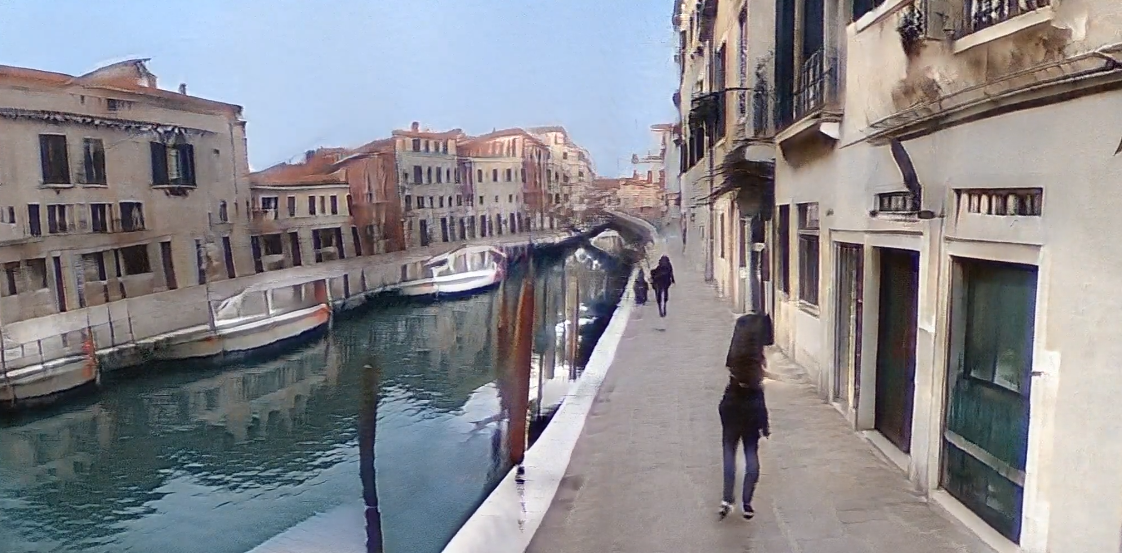
 Strolling Cities - «Прогуливающиеся города» - новый видеопроект из лаборатории искусственного интеллекта MIT-IBM Watson AI Lab

Подробнее здесь: https://www.fastcompany.com/90640772/these-locations-may-look-eerily-familiar-but-none-actually-exist

  1. Визуальной базой были более 2 млн. фото итальянских городов сделанных студентами из Миланского политехнического университета. Во время изоляции они прогуливались по улицам девяти разных итальянских городов, сделав 2 миллиона фотографий этих городских пейзажей, не сверху или на машине, а близко пешком. (Bergamo, Bologna, Catania, Como, Firenze, Genova, Milano, Palermo, Roma, Venezia)
  2. Затем изображения были помечены (такими словами, как «небо» или «окно») с помощью автоматизации, в то время как ИИ был обучен представлять города только из этих изображений.
  3. Отобраны 9 текстов (стихи), посвященные этим городам. Стихи читаются (очевидно, профессиональными чтецами) и накладываются на непрерывные «плавающий» видеоряд, который создается нейросетью на основе банка изображений.
  4. Легко следовать тому, как мыслит ИИ. Упоминание об океане вызывает появление океана, а на тротуарах - пешеходные дорожки. Рассказчик, говоря «воздушная вертикальность», заставляет здания простираться в небо. И иногда, когда нет достаточно четкого итальянского ориентира, такого как упоминание «рисовых полей», система, кажется, делает все возможное, предлагая поле чего-то, что не совсем похоже на траву, но не совсем похоже на рис или что-то еще. То есть эта нейросеть ведет себя не глупее DALL·E.
  5. Получается весьма своеобразный арт-продукт (см. рис. и видео на сайте проекта https://strollingcities.com/index.html#Poems)


Как указывает руководитель проекта Мауро Мартино, мы уже видели всевозможные технически совершенные системы искусственного интеллекта для создания изображений, от воображаемых Google Street View до тюльпанов. Но для построения этих систем требуются груды исходных данных изображений, поэтому большинство ИИ узнают, как выглядят вещи, из общедоступных изображений в Интернете. Это означает, что вы получаете ИИ, который может создавать что-то реалистичное, но эстетически не привлекательное. Это технически точный, скучный средний показатель.

Легко представить педагогические аналогии данного арт-проекта. Ученик читает «Бородино» Лермонтова, а на экране возникают визуальные образы, формирующиеся на основе базы картинок батального, пейзажного, исторического характера. Или ученик отвечает урок по историческому событию, а ИИ создает визуальный образ события, зависящий от полноты и  точности ответа. Мыслимы и игровые загадки-тесты, автоматически формируемые нейросетью на основе введенных учителем текстов.      


среда, 5 июня 2019 г.

Вышел в сборнике МГУ мой обзор "Эпоха МООК как новый этап развития открытого образования"


Большинство материала отражено в этом блоге, тем не менее может быть полезна и эта самокомпиляция. См. статью
Тимкин С.Л. Эпоха массовых открытых онлайн-курсов как этап развития открытого образования // В Сб. Естественнонаучное образование: информационные технологии в высшей и средней школе. Методический ежегодник химического факультета МГУ имени М.В. Ломоносова. Т.15 / Под общ.ред. проф. Г.В. Лисичкина – М.: Издательство Московского университета, 2019. – С. 54-74
Здесь 

пятница, 1 февраля 2019 г.

С опозданием на год. Устойчивая финансовая модель эксплуатации МООК (пересказ наблюдений Дхавал Шаха)


Первоначально все MOOК предлагались как бесплатные курсы. Хотя контент сильно варьировался от курса к курсу, поставщики MOOC по существу предлагали один тип продуктов: университетские курсы, упакованные для онлайн-аудиторий и предлагаемые бесплатно. И лишь 2017 г. появились явные признаки выхода на устойчивую бизнес-модель, которую Дхавал Шах (Class Central) назвал шестиуровневой [1]. К 2017 г. крупные поставщики MOOC разработали продукты и услуги, которые варьируются в цене от бесплатных (или частично свободных) до миллионов долларов. Шестиуровневой моделью называется способ упаковки этих продуктов, сохраняющий их автономность и ценность в объединенном финансовом предложении от вуза-правообладателя. При этом провайдер имеет свою долю от каждого уровня предложения.     
Модель раскрывается на примере программы iMBA Университета штата Иллинойс (см. рис.)
Программа Интернет-МБА (iMBA)  является полностью аккредитованной степенью MBA, упакованной как набор из шести специальностей Coursera. IMBA стартовала в 2015 году, а первая группа студентов окончила в декабре 2017 года.
Шестиуровневая модель монетизации заключается в следующем:
1.  Все курсы, составляющие iMBA, могут свободно посещаться. Это самый нижний, свободный уровень. Более 1.2 миллиона человек посетили курсы iMBA таким образом. При этом они, как правило, имеют доступ только к видеолекциям и прочим материалам, не имея возможности сдать верифицируемый тест/тесты, подтверждающие изучение курса. 
2.      Уровень над свободным уровнем - это сертификат одного курса. Он стоит в среднем 49 долларов за курс в случае курсов iMBA. Около 49 000 таких сертификатов были вручены за курсы iMBA с момента запуска.
3.      Третий уровень цен находится на уровне «микроучетных данных», который представляет собой программу сертификатов, состоящую из нескольких курсов (специализация по терминологии Coursera). Специализации в iMBA стоят от 150 до 300 долларов. Медианная цена для MicroMasters на EDX составляют 946 долларов.
4.      На четвертом уровне цен студенты могут зарабатывать университетский кредит, который может быть применен к традиционной системе степеней (бакалавриату, магистратуре). Это может стоить от нескольких сотен до нескольких тысяч долларов. В случае iMBA стоимость каждого кредита составляет 250 долларов.
5.      На пятом уровне цен находится онлайн-степень. Цена колеблется от нескольких тысяч до десятков тысяч долларов. На этом уровне университеты более активно участвуют и предлагают дополнительные услуги, такие как наставничество, офисные часы, прокторинг экзаменов и другие. IMBA стоит $ 22 тыс. В 2015 г. было зачислено более 800 студентов, что означает потенциальный доход в размере более 17 миллионов долларов.
6.      На шестом и последнем уровне монетизации действует корпоративное обучение, когда работодатели платят за своих сотрудников для доступа к сертификационным курсам и микроучетным данным. Он стоит 400 долларов на сотрудника, чтобы тот получил доступ ко всему каталогу Coursera. Работодатели также имеют доступ к дополнительным функциям, таким как аналитика, отслеживание прогресса команды/сообщества. В зависимости от размера компании доход для Coursera может варьироваться от нескольких тысяч до миллионов долларов. Иногда даже государственные субъекты могут участвовать на этом уровне
В 2018 году провайдеры MOOК сфокусировались на «длинных» программах (или на двух верхних уровнях «шестиуровней монетизации»), а именно: корпоративном обучении и на онлайн-степенях [2]. В результате к началу 2019 г. общее количество онлайн-степеней, основанных на MOOК, превысило 45 по сравнению с 15 в 2017 г. В настоящее время более 10 000 студентов обучаются на них. Но большинство из зарегистрированных студентов поступают только на 3 программы: онлайн-степень магистра в области компьютерных наук (Georgia Tech от Udacity), онлайн-степень магистра в области аналитики (Georgia Tech от edX) и iMBA (Университет Иллинойса от Coursera).

Онлайн-степени как считает Дхавал Шах являются сегодня второй волной «хайпа» МООК. В таблице 4 с использованием [3] сведены данные об онлайн-степенях, которые предлагаю платформы-провайдеры начале 2019 г. По данным таблицы можно сделать ряд полезных заключений:
1. Онлайн-степени реализуются находящимися в первой тройке по количеству онлайн-курсов глобальными англоязычными провайдерами: Coursera, Edx, FutureLear
2. Преобладают программы магистратуры (17), затем МБА (7) и пока единственная программа бакалавриата 
3. Представлены преимущественно программы англосаксонских университетов США, Австралии, Великобритании и всего одна европейская программа.
4. Стоимость программ МБА имеет наименьший разброс и лежит в диапазоне $21-23.5 тыс.
5. Стоимость программам магистратуры варьируется в очень широких пределах от $7000 до $37300, а медианой является значение $18100.
6. Нет корреляции между стоимостью программы и местом университета в мировом QS-рейтинге вузов
Таблица. Программы степеней, объявленные на начало 2019 г. (с указанной стоимостью) 
Степень
Университет
QS ranking Университета, 2018 г.
Платформа
Стоимость
Bachelor of Science in Computer Science
University of London, goldsmiths
398
Coursera
£ 10,088* - £15,132
13316 – 19974
depending upon geographic location of student.
Masters of Science in Computer Science (OMSCS)
Georgia Institute of Technology
70
Udacity
~$7000
Master’s Degree in Cybersecurity
Georgia Tech
70
edX
$9,920
Masters of Science in Analytics (OMS Analytics)
Georgia Institute of Technology
70
edX
< $10,000
Master’s Degree in Computer Science
University of Texas at Austin
67
edX
$10,000
Master’s Degree in Accounting
Indiana University
304
edX
AUD $21,000
14910
Master’s Degree in IT Management
Indiana University
304
edX
AUD $21,000
14910
Master’s Degree in Data Science
University of California, San Diego
38
edX
$15,000
Master of Computer Science
Arizona State University
209
Coursera
$15,000

Master’s Degree in Leadership: Service Innovation
University of Queensland
47
edX
AUD $25,500
18105
Master of Computer Science
University of Illinois
69
Coursera
$19,200 + fees
Master of Computer Science in Data Science
University of Illinois
69
Coursera
$19,200 plus fees
Master’s Degree in Marketing
Curtin University
262
edX
AUD $31,475
22347
Master's in Innovation and Entrepreneurship
HEC Paris
École des hautes études commerciales de Paris
-
Coursera
20,000 EUR
22800

Master of Computer and Information Technology
University of Pennsylvania
19
Coursera
$25,000
Master of Development and Humanitarian Action
Deakin University
293
FutureLearn
AUD 40,704
28900
Master of Science in Accounting (iMSA)
University of Illinois
69
Coursera
~$30,000
Master of Cyber Security
Deakin University
293
FutureLearn
AUD 52.560
37317
MBA with Artificial Intelligence specialism
Coventry University
551-600
FutureLearn
£15,900 GBP
20988
MBA Sustainable Tourism
Coventry University
551-600
FutureLearn
£15,900 GBP
20988
MBA (for the Healthcare sector
Coventry University
551-600
FutureLearn
£15,900 GBP
20988
Masters in Business Administration (MBA)
Coventry University
551-600
FutureLearn
£15,900
20988
MBA (for the Cyber Security Management sector)
Coventry University
551-600
FutureLearn
£15,900
20988
Master of Business Administration (iMBA)
University of Illinois
69
Coursera
~$22,000
Global MBA
Macquarie University
240
Coursera
AUD $33,000
23430

С ростом финансовых поступлений от МООК (увеличением числа платящих пользователей, запуском новых онлайн-степеней и акцентом на корпоративное обучение), связана тенденция уменьшения бесплатного доступа к МООК. Дхавал Шах пишет: «Мы наблюдаем устойчивый сдвиг в акценте на платных пользователях бесплатные пользователи больше не являются основным объектом внимания» [4].
Это касается, прежде всего, все той же тройки лидеров: 
  • ·    Coursera была первой, кто ввел платный доступ для распределенных заданий три года назад. Чтобы получить доступ к оценочным заданиям, студентам необходимо приобрести сертификат. Свободные пользователи все еще могут получить доступ к содержанию курса.
  • ·  Затем, в марте 2017 года, FutureLearn принял платную систему, аналогичную плате Coursera, с добавленной особенностью. В дополнение к наличию платного доступа для распределенных заданий, контент был доступен для бесплатных пользователей только в течение курса и двух недель после его окончания.
  • ·     Теперь в конце 2018 г. и EDX, некоммерческая организация, пришла к модели, похожей на коммерческую компанию Coursera.
Таким образом:
1. Ведущей моделью монетизации становится модель, базирующаяся на плате за обучение или его неотъемлемой части (верифицируемые тесты, экзамен)
2. Значительную роль в монетизации могут сыграть методы «упаковки» МООКов в образовательные программы, охватывающие одновременно несколько уровне образования.  
3. Ни о какой магистратуре за $100, которую обещал Себастьян Трун (Udacity) речи не идет. Тем не менее стоимость онлайн-образовательных программ ниже традиционной в США, где стоимость целой программы магистратуры лежит в диапазоне $23,520-79,317, средняя в государственных университетах составляет $28,375 в год, а в частных вузах и того более - $38,665. Если сравнить с медианной стоимостью из табл.4, то стоимость онлайн-программы лежит на уровне 2/3 от кампусной. При этом следует учесть отсутствие затрат на проживание, поездки, учебную литературу и т.п.
Литература
1.   Dhawal Shah  Six Tiers of MOOC Monetization  // Class Central. 17.01.2018. - Электронный ресурс  https://www.class-central.com/report/six-tiers-mooc-monetization (дата обращения: 23.01.2019)
2.  Dhawal Shah  Year of MOOC-based Degrees: A Review of MOOC Stats and Trends in 2018 // Class Central. 06.01.2019. - Электронный ресурс : https://www.class-central.com/report/moocs-stats-and-trends-2018/ (дата обращения: 23.01.2019)
3.  МOOC-based Degrees. Pricing Chart  Электронный ресурс:   https://www.class-central.com/pricing-charts/mooc-based-degrees (дата обращения: 23.01.2019) 
4.  Dhawal Shah  EdX Puts Up A Paywall for Graded Assignments   // Class Central. 17.12.2018. - Электронный ресурс: https://www.class-central.com/report/edx-paywall-graded-assignments/ (дата обращения: 23.01.2019)